Service de récupération de données web, piloté par l'IA
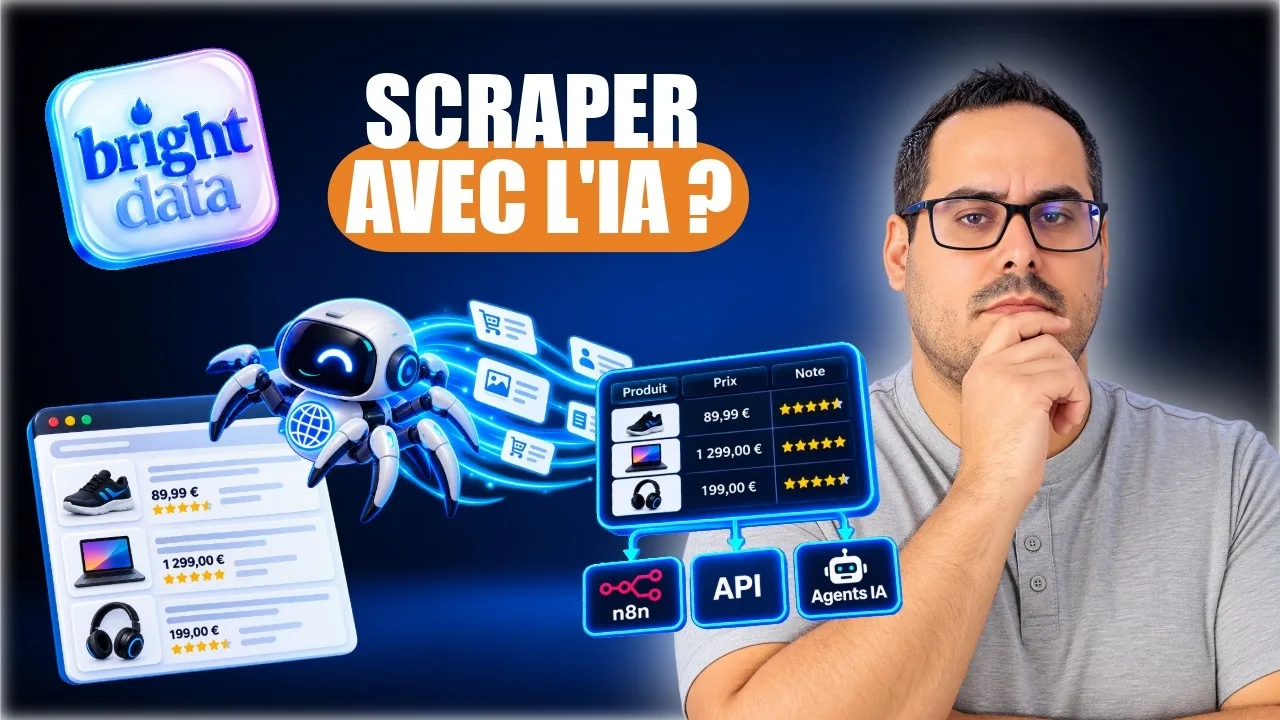
Un service qui récupère le contenu de n'importe quelle page web et en extrait les informations demandées en langage courant, prêt à être appelé par n8n, une application ou un agent IA.
- 2 jours de projet
- 2026
- Open source
- API · Automatisation
La solution
Une surcouche autour de ScrapeGraphAI qui en fait un service à installer sur son propre serveur : on lui donne une adresse et une consigne, il rend le contenu ou les données demandées, et dit comment la page a été obtenue et ce que ça a coûté. Le code est publié en open source.
- 01Page en texte lisible
Le service rend le contenu d'une page, liens compris, prêt à être lu par une IA.
- 02Extraction en langage courant
On décrit les informations voulues, l'IA les extrait et vérifie chaque valeur dans la page.
- 03Recherche web
Une recherche Google, puis chaque résultat récupéré et, au besoin, analysé.
- 04Exploration d'un site
Les pages d'un site sont parcourues en tâche de fond, dans le respect de ses règles.
- 05Passage des blocages
Quand un site bloque, le service passe à un accès plus robuste, et retient ce qu'il faut pour la fois suivante.
- 06Coût de chaque appel
Chaque réponse indique comment la page a été obtenue et combien elle a coûté.
Avec quoi on l'a construit
- Python
- Claude
- PostgreSQL
- Docker
- Coolify
Les étapes du projet
- 1RepriseLe projet open source ScrapeGraphAI repris comme base.
- 2DéveloppementLe service web, l'extraction par l'IA et l'accès par paliers aux sites.
- 3Mise en ligneUne image prête à installer sur son serveur, et la documentation.
- 4PartageLe code publié en open source et présenté en vidéo.
D'autres projets
Un projet similaire ?
Décrivez votre besoin en deux minutes, on revient vers vous avec une piste concrète.